 Monster Cone
Tesseract 已经更新到了 5.0 版本,从 4.0 版本开始就可以使用 LSTM 模型进行训练了,相对于 4.0 版本之前的训练方法,通过 LSTM 模型训练更简单,准确率也更高。
训练准备工作
- 待训练图片
- jTessBoxEditor 工具
- 已安装有训练工具的 Tesseract-OCR
训练流程
生成 tif 文件
使用 jTessBoxEditor 工具生成 tif 文件。
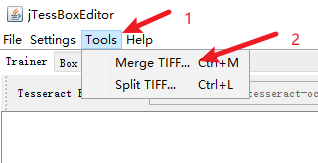
在弹窗中选择你所有需要训练的图片,然后保存 tif 文件,文件名为你的字体名。例如 num.tif,我要生成的字体就是 num。
生成 box 文件
进入我们存放 num.tif 的文件夹,执行以下命令:
tesseract num.tif num -l eng --psm 6 lstmbox- tesseract: Tesseract-OCR 命令
- num.tif: 识别的 tif 文件
- num: 生成的 box 文件名
- -l eng: 指定 eng 模型进行识别
- —psm 6: 跟 tessearct 识别的 psm 参数一样,这里 6 表示使用 OSD 分割模式,自动检测文本的方向和脚本。
- lstmbox: 输出 LSTM 网络的盒子坐标文件
我们将得到 num.box 文件,它的内容如下:
6 2 2 73 21 0
7 2 2 73 21 0
0 2 2 73 21 0
4 2 2 73 21 0
8 2 2 73 21 0
	 2 2 73 21 0
B 0 0 73 21 1
8 0 0 73 21 1
3 0 0 73 21 1
	 0 0 73 21 1
... 其他数据
以第一行数据为例: 6: 表示这张图片的第一个识别字符是 6 2 2 73 21: 表示这张图片的识别结果的盒坐标 0: 表示 tif 图片中的索引,也可以认为是第几张图片,从 0 开始计数
LSTM 的 box 文件跟之前的 box 文件区别在于它以整行来进行识别,所有识别的字符盒坐标都是整个识别结果的坐标,不是单个字符的盒坐标。
修正识别结果,生成 lstmf 训练模型
在修正完错误的识别结果后,执行以下命令生成 lstmf 文件:
tesseract num.tif num -l eng --psm 6 lstm.train前面参数跟上一步相同,最后的 lstm.train 表示生成 lstmf 文件,我们将得到 num.lstmf 文件
提取已训练的 lstmf
LSTM 训练是在已完成训练模型基础上继续进行训练的方法,所以必须基于已完成训练的 lstmf。我们上面指定了 eng 语言进行识别,所以我们从 eng.traineddata 中提取 lstmf。
combine_tessdata -e eng.traineddata eng.lstm- combine_tessdata: Tesseract 工具
- -e eng.traineddata: 从 eng.traineddata 中提取特定模型
- eng.lstm: 提取目标名称
我们将得到一个 eng.lstm 文件
traineddata 必须使用 tessdata_best 库中的字体。
开始训练
我们现在有 eng.lstm、eng.traineddata、num.lstmf 文件,将他们放在同一文件夹中,创建一个 output 文件夹,再创建一个 num.training_files.txt 文件,内容是 num.lstmf 文件的路径。
目录结构如下:
LSTM_train
│  eng.lstm
│  eng.traineddata
│  num.lstmf
│  num.training_files.txt
│
└─output
然后执行以下命令进行训练:
lstmtraining --debug_interval -1 --max_iterations 10000 --target_error_rate 0.01 --continue_from=".\eng.lstm" --model_output=".\output\output" --train_listfile=".\num.training_files.txt" --traineddata=".\eng.traineddata"- lstmtraining: Tesseract 工具,用于训练 LSTM 模型
- —debug_interval -1: 禁用调试输出
- —max_iterations 10000: 指定训练的最大迭代次数,即训练的轮数
- —target_error_rate 0.01: 目标错误率,当训练误差率达到这个值时,训练会停止。(没达到目标错误率,达到了最大迭代次数也会停止)
- —continue_from=”.\eng.lstm”: 指定已训练好的 lstm 模型
- —model_output=”.\output\output” : 训练完成的模型输出路径
- —train_listfile=”.\num.training_files.txt”: 要训练的图片文件路径,指 lstmf 文件。
- —traineddata=”.\eng.traineddata”: 用于训练的基础数据
训练完成后我们将得到这样的结果
At iteration 100/100/100, Mean rms=3.709000%, delta=21.513000%, BCER train=69.175000%, BWER train=99.000000%, skip ratio=0.000000%,  New best BCER = 69.175000 wrote best model:.\output\output_69.175000_100_100.checkpoint wrote checkpoint.

Finished! Selected model with minimal training error rate (BCER) = 69.175
表示最佳训练模型是 output_69.175000_100_100.checkpoint,识别错误率为 69.175,这只是示例,所以错误率较高。
生成字体文件
我们将根据 output_69.175000_100_100.checkpoint 模型生成字体文件,使用以下命令:
lstmtraining --stop_training --traineddata=".\eng.traineddata" --model_output=".\num.traineddata" --continue_from=".\output\output_69.175000_100_100.checkpoint"- lstmtraining: Tesseract 工具,用于训练 LSTM 模型
- —stop_training: 停止训练
- —traineddata=”.\eng.traineddata”: 基础数据,将和训练数据进行合并输出
- —model_output=”.\num.traineddata”: 训练字体输出路径
- —continue_from=”.\output\output_69.175000_100_100.checkpoint”: 选择输出字体的模型
我们将在当前目录下得到 num.traineddata 文件,将它放在放在你 Tesseract-OCR 安装路径下的 tessdata 文件夹中,就可以使用这个字体了。